
简体中文(默认) | English
StatsPAI:面向 Agent 设计的 Stata/R 平替


由 Stanford REAP 团队开发和维护
论文已发表于 Journal of Open Source Software(JOSS):Wang & Rozelle (2026), 11(125), 10604 · doi:10.21105/joss.10604
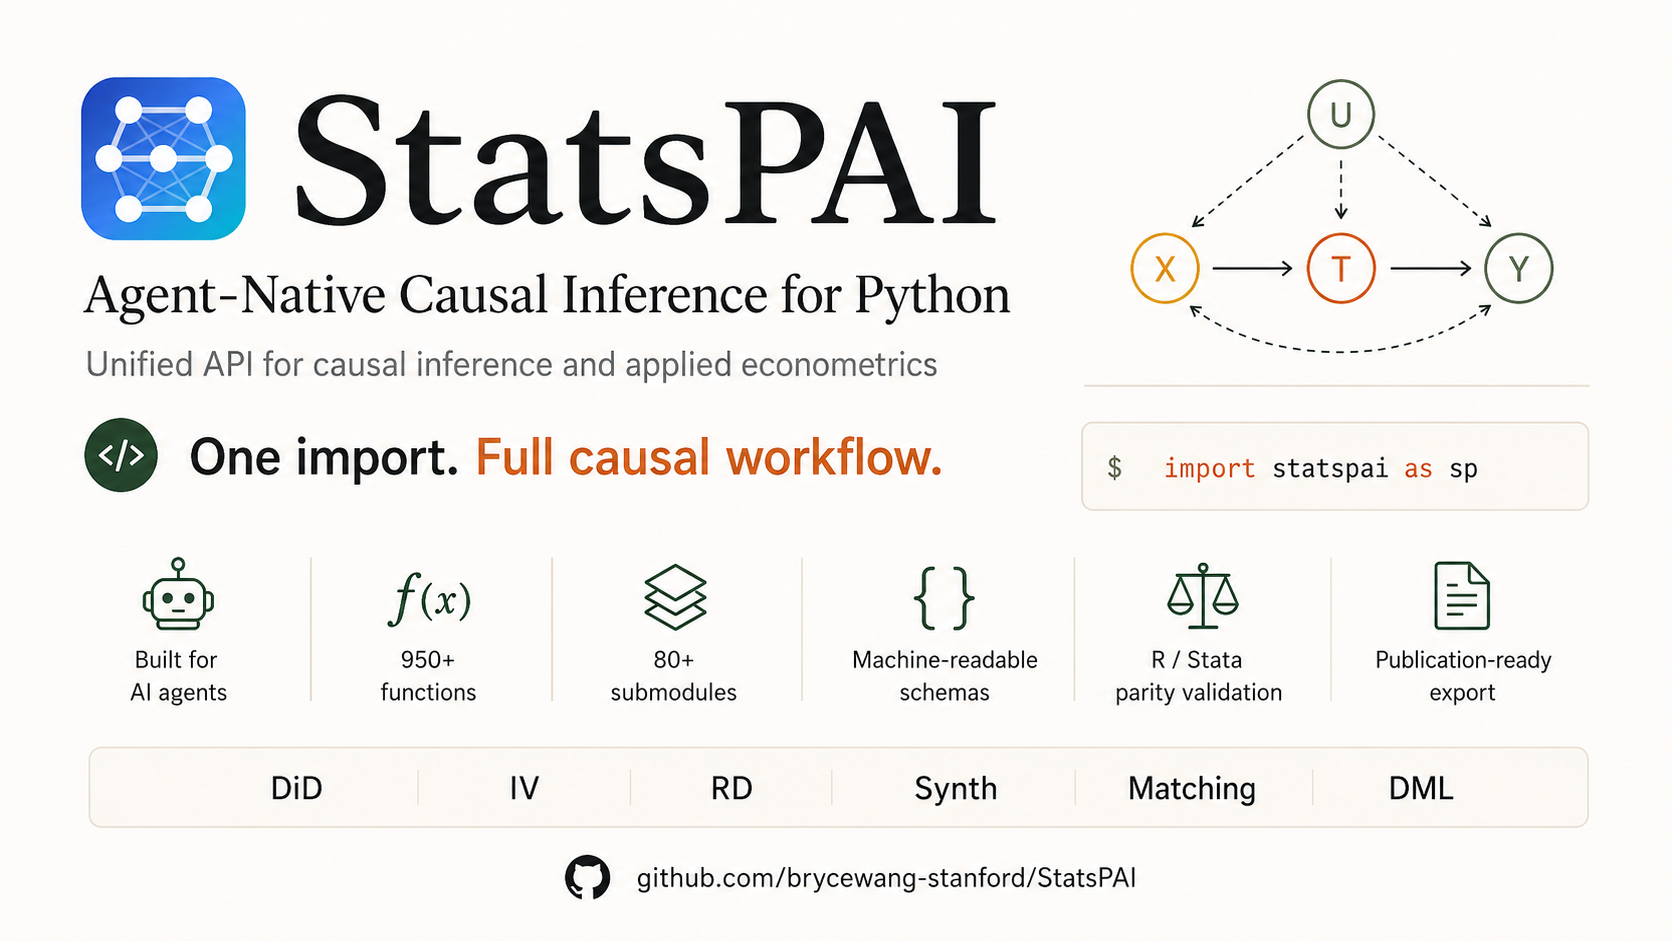
StatsPAI 面向那些原本需要在 Stata、R 和 Python 之间来回切换的实证研究者。它的目标很直接:把常见的计量经济学、因果推断、诊断、稳健性、表格导出和 Agent 可读元数据,放到一个 Python-native API 里。
你可以把它理解成新项目的 Stata/R 平替入口:
- Stata 风格:
regress、ivregress、reghdfe、csdid、rdrobust、synth、psmatch2、esttab/outreg2。 - R 风格:
lm、fixest、did、rdrobust、Synth、DoubleML、MatchIt、modelsummary、broom。 - 关键处遵循 Stata 约定:
regress、ivreg和各类似然估计器都接受vce="robust"/vce="cluster firm",稳健 / 聚类标准误采用 Stata 的小样本修正和 z / t 参考分布;任何拟合结果之后都可以做test/lincom/margins, dydx();已有的 Stata 命令行可直接用sp.stata("...", data=df)运行。 - Python 输出:在支持的结果对象上直接用
.summary()、.tidy()、.plot()、.to_latex()、.to_docx()、.to_agent_summary()。 - Agent 原生:每个公开函数都在注册表里带机器可读 schema(
sp.list_functions()、sp.describe_function()、sp.function_schema()),随包附带的statspai-mcp服务把估计器暴露给 Claude Code、Claude Desktop、Cursor 等 MCP 客户端。 - Stata Agent 协同:我们自己开发的
stata-code
- Skills repo 协同:
Auto-Empirical-Research-Skills、
AER-Skills、
Awesome-Journal-Skills
和 Paper-WorkFlow
可以和 StatsPAI 以及 agent 一起使用,作为方法选择、期刊要求、论文流程和可复现检查的技能层。
这不是说每个 Stata/R 命令都已经逐字节复现。API 覆盖面很广,但背后的数值证据并不均匀:有的估计器在同一份数据上与 R/Stata 逐一对照过,有的只用已知真值的模拟验证过,还有很多目前只承诺接口稳定、没有数值对齐声明。每个函数都带有 validation_status 标明属于哪种情况(certified / validated / api_stable):certified / validated 两档有数值证据,api_stable 只表示接口稳定。论文要用某个数字之前,请先看验证状态。
安装
pip install statspai支持 Python 3.9 – 3.13。核心安装已包含估计、诊断、内置数据集,以及 .xlsx / .docx / LaTeX 导出。画图和较重的后端是可选 extras:
| Extra | 增加 | 用途 |
| --- | --- | --- |
| statspai[plotting] | matplotlib、seaborn、plotly | .plot()、sp.ggdid()、sp.interactive() 等图形 |
| statspai[fixest] | pyfixest(Python ≥ 3.10) | sp.fixest.* 封装,以及交叉验证中的 pyfixest 引擎 |
| statspai[bayes] | PyMC、ArviZ | 贝叶斯估计器 |
| statspai[neural] / statspai[deepiv] | PyTorch | 神经网络因果模型、DeepIV |
| statspai[performance] | JAX | 加速后端 |
| statspai[spatial] | geopandas、libpysal、shapely | shapefile / 几何空间权重 |
交互式图表编辑器在 Jupyter 里还需要 ipywidgets。
import statspai as sp
print(sp.datasets.list_datasets()[["name", "design", "source"]])
StatsPAI 内置 14 个可离线加载的数据集。大部分是真实的已发表数据(source == "bundled CSV"):Card (1995) NLSYM 教育回报数据、带 PSID 对照组的 LaLonde/NSW、R rdrobust 附带的美国参议院 RD 数据、California Proposition 99、castle-doctrine 面板、NHEFS 等。少数是按已发表设计校准的确定性模拟复刻(source == "simulated"),包括下面用到的 Callaway–Sant'Anna mpdta 面板——它们的数字不是原始数据上的数字。
一眼概览:1,280 个注册函数,分布在 87 个子模块;467k 行核心代码 + 305k 行测试。运行 python scripts/registry_stats.py 可复现这些数字。
如果你原来用 Stata 或 R
| 原来的工作流 | Stata / R 写法 | StatsPAI 入口 |
| --- | --- | --- |
| OLS / 稳健标准误 | reg y x, vce(robust) / lm() + sandwich | sp.regress("y ~ x", data=df, vce="robust") |
| 聚类标准误 | vce(cluster firm) / sandwich::vcovCL()、feols(..., cluster = ~firm) | vce="cluster firm"(或 cluster="firm");sp.feols(..., cluster="firm") |
| Logit / probit / 计数模型 | logit、probit、poisson、nbreg / glm()、MASS::glm.nb() | sp.logit()、sp.probit()、sp.poisson()、sp.nbreg()、sp.glm() |
| IV / 2SLS | ivregress 2sls / AER::ivreg() | sp.ivreg("y ~ (d ~ z) + x", data=df) |
| 高维固定效应 | reghdfe / fixest::feols() | sp.feols("y ~ x \| firm + year", data=df) |
| 交错 DiD | csdid / did::att_gt() | sp.callaway_santanna() + sp.aggte() |
| 断点回归 | rdrobust / rdrobust::rdrobust() | sp.rdrobust() |
| 合成控制 | synth / Synth::synth() | sp.synth() |
| 匹配 / PSM | psmatch2 / MatchIt | sp.psmatch2()、sp.match() |
| 双重机器学习 | ddml / DoubleML | sp.dml() |
| 估计后检验 | test、lincom、margins, dydx() | fit.test()、fit.lincom()、sp.margins(fit) |
| 论文表格 | esttab、outreg2 / modelsummary | sp.regtable() |
| 直接运行 Stata 命令行 | 一段 .do 代码 | sp.stata("logit y x, vce(cluster id)\nmargins, dydx(x)", data=df) |
| 翻译命令 | — | sp.from_stata("reghdfe y x, absorb(id year)")、sp.from_r("feols(...)") |
在 regress、ivreg、glm、logit、probit、poisson、nbreg、有序 / 多项 / 条件 logit、零膨胀与 hurdle 模型、liml 等估计器上,vce= / robust= 遵循 Stata 的 vce() 语法(sp.feols 保留 fixest 的 vcov= / cluster=):True、"robust"、"vce(robust)"、"oim"、"hc0"–"hc3",以及直接写出聚类变量("cluster firm"、"vce(cluster firm)"、"cl firm")。估计器不支持的写法会直接报错,而不是悄悄换成另一种标准误。稳健和聚类标准误采用 Stata 的小样本因子,聚类的 OLS / IV 用 t(G-1),基于似然的估计报告 z。29 个估计器的 oim / robust / cluster 标准误以 1e-6 的对齐预算钉在 Stata 18 上(另有三处有文档的例外:两边优化器停在略微不同的点)。详见统一参数语法。
因果估计入口在各自原生参数名之外,还接受一套统一的参数名:面板个体用 id=,时间用 time=,处理批次用 first_treat=,协变量用 covariates=,RD 用 running= / cutoff=。sp.callaway_santanna(data=mp, y="lemp", time="year", id="countyreal", first_treat="first_treat") 与下文 t= / i= / g= 的写法完全等价;拼错的参数会提示最接近的名字(runing= → "did you mean 'running'?"),sp.describe_function(name)["aliases"] 列出所有可用写法。
sp.esttab()、sp.outreg2()、sp.modelsummary() 仍然可用,但已是 sp.regtable() 的弃用薄封装,调用时会发出 DeprecationWarning。
和其他 Python 包的对比
StatsPAI 想做的是一个覆盖面广的 Stata/R 风格实证工作台。下面这些专注型 Python 包各自做好其中一部分,而且往往历史更长;如果你只需要那一部分,它们都是很好的选择。
| 包 | 专注于什么 | 与 StatsPAI 的关系 |
| --- | --- | --- |
| pyfixest | fixest 风格的高维固定效应 OLS / IV / GLM、事件研究 DiD、wild bootstrap、表格 | StatsPAI 有自己的 sp.feols(与 R fixest 对照过),并把 pyfixest 作为可选封装和交叉验证引擎。 |
| linearmodels | 面板模型、IV / GMM、系统估计 | StatsPAI 面板模块的部分功能依赖它(核心依赖),也是 sp.cross_validate 的独立引擎之一。 |
| DoubleML | 双重/去偏机器学习(PLR、PLIV、IRM、IIVM),有 R 孪生包 | sp.dml 在相同学习器和折分下与 DoubleML 对照过。 |
| EconML | 异质处理效应:DML、因果森林、DR learner、IV、策略学习 | sp.metalearner 与 EconML 的 S/T/X learner 对照过。 |
| DoWhy | 基于因果图的 建模 → 识别 → 估计 → 反驳 流程;图因果模型 | StatsPAI 也有 DAG 和因果发现工具,但以估计器为中心,而非以因果图为中心。 |
| CausalPy | 以 PyMC 贝叶斯为主(也支持 scikit-learn OLS)的准实验分析:DiD、合成控制、RD、ITS、IV | StatsPAI 以频率学派计量惯例为中心(聚类 / 稳健标准误、偏差校正 RD、CS-DiD 聚合),并提供跨语言对齐证据。 |
| causallib | scikit-learn 风格的 IPW、标准化、双重稳健估计和因果评估 | StatsPAI 在同一个 API 里同时覆盖这些方法以及回归、面板、DiD、RD、合成控制工作流。 |
如果你想要一个包、一个函数注册表、一个 Agent 接口来覆盖日常 Stata/R 实证工作流,StatsPAI 更贴近这个目标。
新手案例:代码和结果一起看
下面的输出由 StatsPAI 1.29.0 在内置数据集上实际运行得到。例 6 用到的 Stata vce() 语法和估计后命令自 1.29.0 起进入发行版;在更早的版本上可用 pip install "statspai @ git+https://github.com/brycewang-stanford/StatsPAI" 从源码安装。较长的 summary 做了节选(... 表示省略的行);这些数字由 tests/test_readme_examples.py 和 tests/test_synth_placebo_pvalue.py 钉住,今后不会再悄悄与代码脱节。
1. OLS:替代第一条 regress / lm
问题:在 Card (1995) NLSYM 数据中,多上一年学和 log wage 的关系有多大?
import statspai as sp
card = sp.datasets.card_1995()
ols = sp.regress(
    "lwage ~ educ + exper + expersq + black + south + smsa",
    data=card,
    robust="hc1",
)
print(ols.summary())
结果:
Model: OLS
Method: Least Squares
Dependent Variable: lwage
...
           Coefficient  Std. Error  t-statistic  P>|t|  [0.025  0.975]
Intercept       4.7337      0.0702      67.4718 0.0000  4.5961  4.8712
educ            0.0740      0.0036      20.3208 0.0000  0.0669  0.0812
exper           0.0836      0.0067      12.4165 0.0000  0.0704  0.0968
expersq        -0.0022      0.0003      -7.0443 0.0000 -0.0029 -0.0016
black          -0.1896      0.0174     -10.8781 0.0000 -0.2238 -0.1555
south          -0.1249      0.0154      -8.1339 0.0000 -0.1550 -0.0948
smsa            0.1614      0.0152      10.6374 0.0000  0.1317  0.1912
Model Diagnostics:
--------------------
R-squared           : 0.2905
...
像读 Stata/R 回归表一样读:控制经验、种族、地区和 SMSA 之后,多上一年学与 log wage 高约 0.074(约 7.4%)相关。这还只是相关,不是因果回报:受教育年限很可能与不可观测的能力相关,这正是例 2 用 IV 的原因。HC1 标准误与 Stata vce(robust) / sandwich::vcovHC(type = "HC1") 的约定一致。
2. IV / 2SLS:替代 ivregress 2sls 或 AER::ivreg
问题:用成长地附近是否有四年制大学(nearc4)作为受教育年限的工具变量。
import statspai as sp
card = sp.datasets.card_1995()
iv = sp.ivreg(
    "lwage ~ (educ ~ nearc4) + exper + expersq + black + south + smsa",
    data=card,
)
print(iv.summary())
结果:
Model: IV-2SLS
Method: Two-Stage Least Squares
Dependent Variable: lwage
...
           Coefficient  Std. Error  t-statistic  P>|t|  [0.025  0.975]
...
educ            0.1323      0.0492       2.6870 0.0072  0.0358  0.2288
Model Diagnostics:
...
First-stage F (educ)        : 16.7176
...
Partial R² (educ)           : 0.0055
Hausman F-stat              : 1.5390
Hausman p-value             : 0.2149
IV 估计(0.132)比 OLS 大,但精度低了约 13 倍。工具变量并不强——nearc4 只解释受教育年限 0.55% 的残差变异(一阶段 F ≈ 16.7)——而且 Hausman 检验不拒绝 educ 外生(p = 0.21)。默认标准误是非稳健标准误,带 AER::ivreg 的小样本自由度修正(对应 Stata ivregress 2sls ..., small);需要异方差稳健标准误时传 robust="hc1",此时一阶段 F 也改用同一个方差估计量,与 Stata estat firststage 一致。
一阶段这么弱时,应同时报告对弱工具稳健的置信区间:
ar = sp.anderson_rubin_ci(
    y="lwage", endog="educ", instruments=["nearc4"],
    exog=["exper", "expersq", "black", "south", "smsa"], data=card,
)
print(ar.summary())
Anderson-Rubin (AR) — weak-IV-robust confidence set
------------------------------------------------------------
level : 95%
grid : 401 points on [-0.359, 0.624]
confidence set : [0.0384, 0.2612]3. 交错 DiD:替代 csdid 或 R did
问题:在 Callaway–Sant'Anna mpdta 设计里,最低工资上调对青少年就业的平均影响是多少?
import statspai as sp
mp = sp.datasets.mpdta()   # R did 包 mpdta 的模拟复刻
gt = sp.callaway_santanna(
    data=mp,
    y="lemp",
    t="year",
    i="countyreal",
    g="first_treat",
)
overall = sp.aggte(gt, type="simple", bstrap=False)
print(overall.summary())
结果:
==============================================================================
  Callaway and Sant'Anna (2021) — aggte[simple]
==============================================================================
ATT:      -0.0330 *
  Std. Error:  (0.0078)
  [95% CI]:    [-0.0482,  -0.0178]
  P-value:     <0.001
...
  Observations:    2,500
...
聚合后的 ATT 约为 -0.033 个对数点,估计很精确。内置的 mpdta 是校准过的模拟复刻,所以这不是 R 在原始 mpdta 数据上报告的数字。核验过的是:同一份 CSV 交给 R did::att_gt() + aggte() 和 Stata csdid,得到相同的 ATT 和标准误(Track A 对齐模块 04_csdid)。
4. RD:替代 rdrobust
问题:美国参议院选举中,在胜负差为 0 的断点处是否存在政党在位优势?
import statspai as sp
senate = sp.datasets.lee_2008_senate()  # rdrobust 的参议院数据:x = 胜负差,y = 得票率
rd = sp.rdrobust(data=senate, y="y", x="x", c=0)
print(rd.summary())
结果:
==============================================================================
  Sharp RD Estimation
==============================================================================
RD Effect:       7.51 *
  Std. Error:  (1.74)
  [95% CI]:    [4.09,  10.92]
  P-value:     <0.001
------------------------------------------------------------------------------
  Inference
------------------------------------------------------------------------------
      method  estimate     se      z  pvalue  ci_lower  ci_upper
Conventional    7.4141 1.4587 5.0826  0.0000    4.5551   10.2732
      Robust    7.5065 1.7413 4.3110  0.0000    4.0937   10.9193
------------------------------------------------------------------------------
  Observations:    1,297
...
  Bandwidth H:    17.7544
  Bandwidth B:    28.0281
...
  N Effective Left:    360
  N Effective Right:    323
...
数据是 Cattaneo, Frandsen & Titiunik (2015, doi:10.1515/jci-2013-0010) 构建、随 R rdrobust 发布的节选(加载函数沿用了历史名称):按 rdrobust 自带示例的定义,x 是政党在第 t 次选举中的得票差,y 是其在第 t+2 次选举中的得票率(0–100)。在 t 期险胜使 t+2 期得票率提高约 7.4 个百分点(常规估计),稳健偏差校正后为 7.5;首行报告的是稳健偏差校正的估计和置信区间。在这份数据上,默认 MSE 最优带宽、估计值和标准误与 R rdrobust::rdrobust() 及 Stata rdrobust 一致(Track A 对齐模块 06_rd)。样本量是 1,297,因为有 93 行结果变量缺失。
5. 合成控制:替代 Stata/R synth
问题:California Proposition 99 对香烟销量有什么影响?
import statspai as sp
prop99 = sp.datasets.california_prop99()
sc = sp.synth(
    data=prop99,
    outcome="cigsale",
    unit="state",
    time="year",
    treated_unit="California",
    treatment_time=1989,
)
print(sc.summary())
结果:
==============================================================================
  Synthetic Control Method
==============================================================================
ATT:      -19.8 *
  Std. Error:  (11.2)
  [95% CI]:    [-41.8,  2.3]
  P-value:     0.077
------------------------------------------------------------------------------
  Detailed Estimates
------------------------------------------------------------------------------
         unit  weight
         Utah  0.3768
      Montana  0.2831
       Nevada  0.1881
  Connecticut  0.0690
New Hampshire  0.0439
     Colorado  0.0391
...
干预后 California 的人均香烟销量每年大约少了 20 包。p 值是 in-space placebo 排序:
California 的 post/pre RMSPE 比值在 39 个州里排第 3,所以 p = 3/39 ≈ 0.077。
这个默认设定只用干预前的结果变量做匹配;如需 ADH 风格的预测变量设定,可传入
covariates=(例如 ["lnincome", "retprice", "age15to24", "beer"])。
这条路径会对每个 placebo 州重新求解嵌套 V-W 问题,明显更慢:可传 n_jobs=-1 并行拟合 placebo(结果逐位一致),调试设定时也可先用 placebo=False。
读这个数字时要带上它的前提(完整 summary 里也会打印):在真实数据上,经典 SCM 的权重往往不是唯一识别的,不同的正确求解器可能落在不同的 donor 权重上。StatsPAI 的原生求解器在唯一识别的设计上经过认证,其他情形标注为"依赖识别"。在这个设定上,R Synth 得到的 ATT 约为 -19.59 而不是 -19.76;需要 R 的精确数字时,传 backend="synth"(需要本机装有 R 和 Synth 包,只支持结果滞后项设定)。
6. Logit、聚类标准误与估计后命令:替代 Stata 的 logit + margins
问题:在 Thornton 的马拉维实验里,随机提供的现金激励让人们去领取 HIV 检测结果的概率提高了多少?以村为聚类。
import statspai as sp
hiv = sp.datasets.thornton_hiv(complete_case=True)
fit = sp.logit("got ~ any + distvct + male + age", data=hiv,
               vce="cluster villnum")
print(fit.summary())
print(sp.margins(fit, variables=["any"]).round(4))   # margins, dydx(any)
结果:
Model: Logit
Method: Maximum Likelihood (Newton-Raphson)
Dependent Variable: got
...
           Coefficient  Std. Error  z-statistic  P>|z|  [0.025  0.975]
Intercept      -0.6370      0.2010      -3.1691 0.0015 -1.0310 -0.2431
any             2.0178      0.0994      20.3029 0.0000  1.8230  2.2126
distvct        -0.1696      0.0408      -4.1610 0.0000 -0.2496 -0.0897
male           -0.0530      0.1051      -0.5046 0.6139 -0.2590  0.1529
age             0.0100      0.0034       2.9046 0.0037  0.0032  0.0167
...
variable dy/dx se z pvalue ci_lower ci_upper
0 any 0.3558 0.0145 24.5453 0.0 0.3274 0.3843和 Stata 一样,age 或村编号缺失的 9 行不进入估计样本(N = 2,825,119 个村);其中因聚类变量缺失而剔除的 4 行会以 StatsPAIWarning 提示,并记录在 fit.model_info["n_missing_cluster_dropped"]。
logit 系数在对数几率尺度上;sp.margins 报告的是 Stata margins, dydx(any) 报告的量——概率上的平均边际效应,配 delta 方法标准误。获得任意激励使领取结果的概率提高约 36 个百分点。系数、按村聚类的标准误和边际效应都与 Stata 18 的 logit ..., vce(cluster villnum) 加 margins, dydx(any) 一致(0.3558466,SE 0.0144976)。
检验和线性组合使用完整协方差矩阵以及该拟合自己的参考分布(这里是 χ² / z,OLS 之后是 F / t):
fit.test("distvct = 0")    # chi2(1) = 17.31, p < 0.001  (Stata: test distvct)
fit.lincom("any + male")   # 1.9648, SE 0.1412           (Stata: lincom any + male)
如果手上已经有 Stata 命令,可以原样运行:
ame = sp.stata("""
logit got any distvct male age, vce(cluster villnum)
margins, dydx(any)
""", data=hiv)
sp.stata 返回最后一行的输出——这里就是同一张边际效应表。无法忠实翻译的命令(例如缺少 xtset 所提供面板 id 的 xtreg, fe)会直接报错,而不是跑一个不同的模型;只想看对应的 Python 调用而不运行,用 sp.from_stata(line)。
导出结果
sp.regtable() 是所有导出格式背后唯一的表格构建器。表格建一次,再输出成合作者需要的任何格式:
import statspai as sp
card = sp.datasets.card_1995()
m1 = sp.regress("lwage ~ educ", data=card, robust="hc1")
m2 = sp.regress("lwage ~ educ + exper + expersq", data=card, robust="hc1")
m3 = sp.regress("lwage ~ educ + exper + expersq + black + south + smsa",
                data=card, robust="hc1")
m4 = sp.ivreg("lwage ~ (educ ~ nearc4) + exper + expersq + black + south + smsa",
              data=card, robust="hc1")
tbl = sp.regtable(
    m1, m2, m3, m4,
    model_labels=["OLS (1)", "OLS (2)", "OLS (3)", "2SLS (4)"],
    coef_labels={"educ": "Years of schooling", "exper": "Experience",
                 "expersq": "Experience squared", "black": "Black",
                 "south": "South", "smsa": "SMSA"},
    drop=["Intercept"],
    title="Returns to Schooling (Card 1995)",
    notes=["HC1 robust SE. Column (4) instruments schooling with nearc4."],
)
print(tbl)                    # 终端
tbl.to_excel("table1.xlsx")   # Excel
tbl.to_word("table1.docx")    # Word
tbl.to_latex()                # LaTeX 源码;另有 .to_markdown()、.to_html()
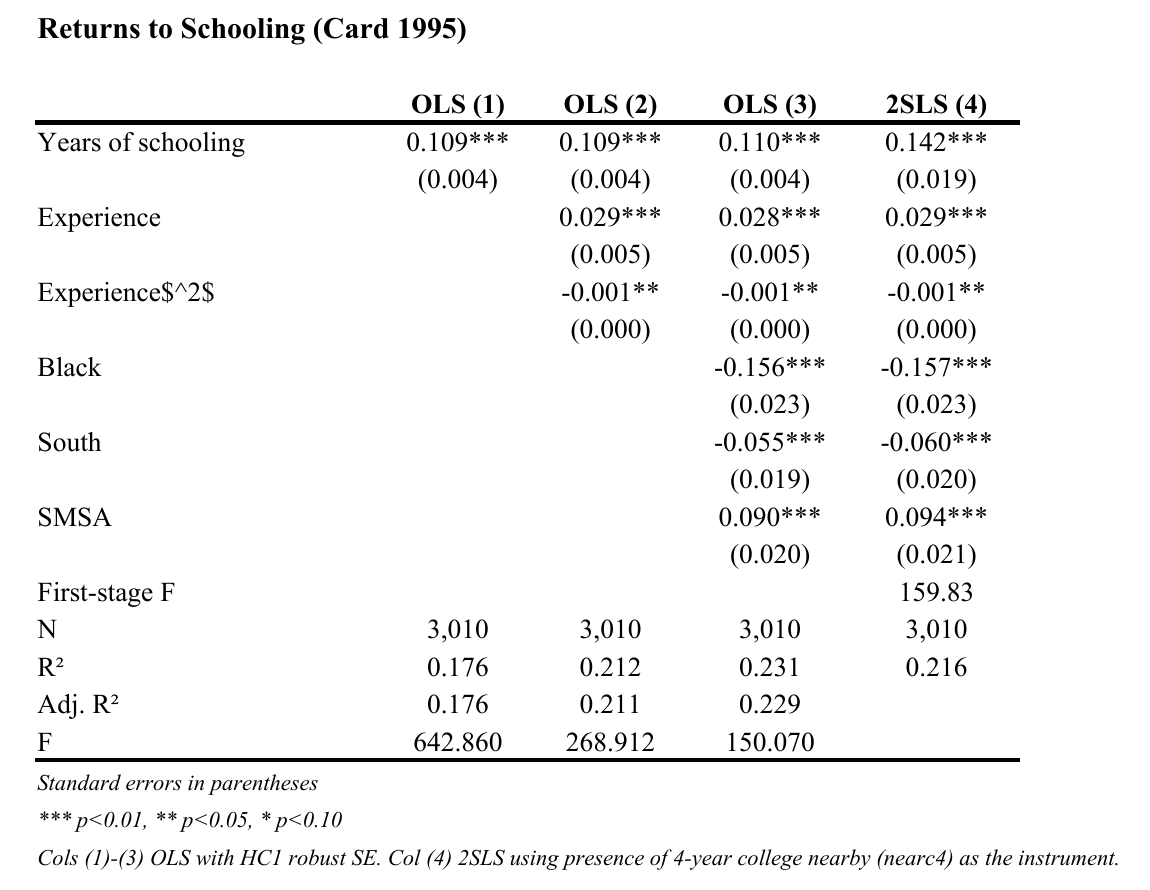
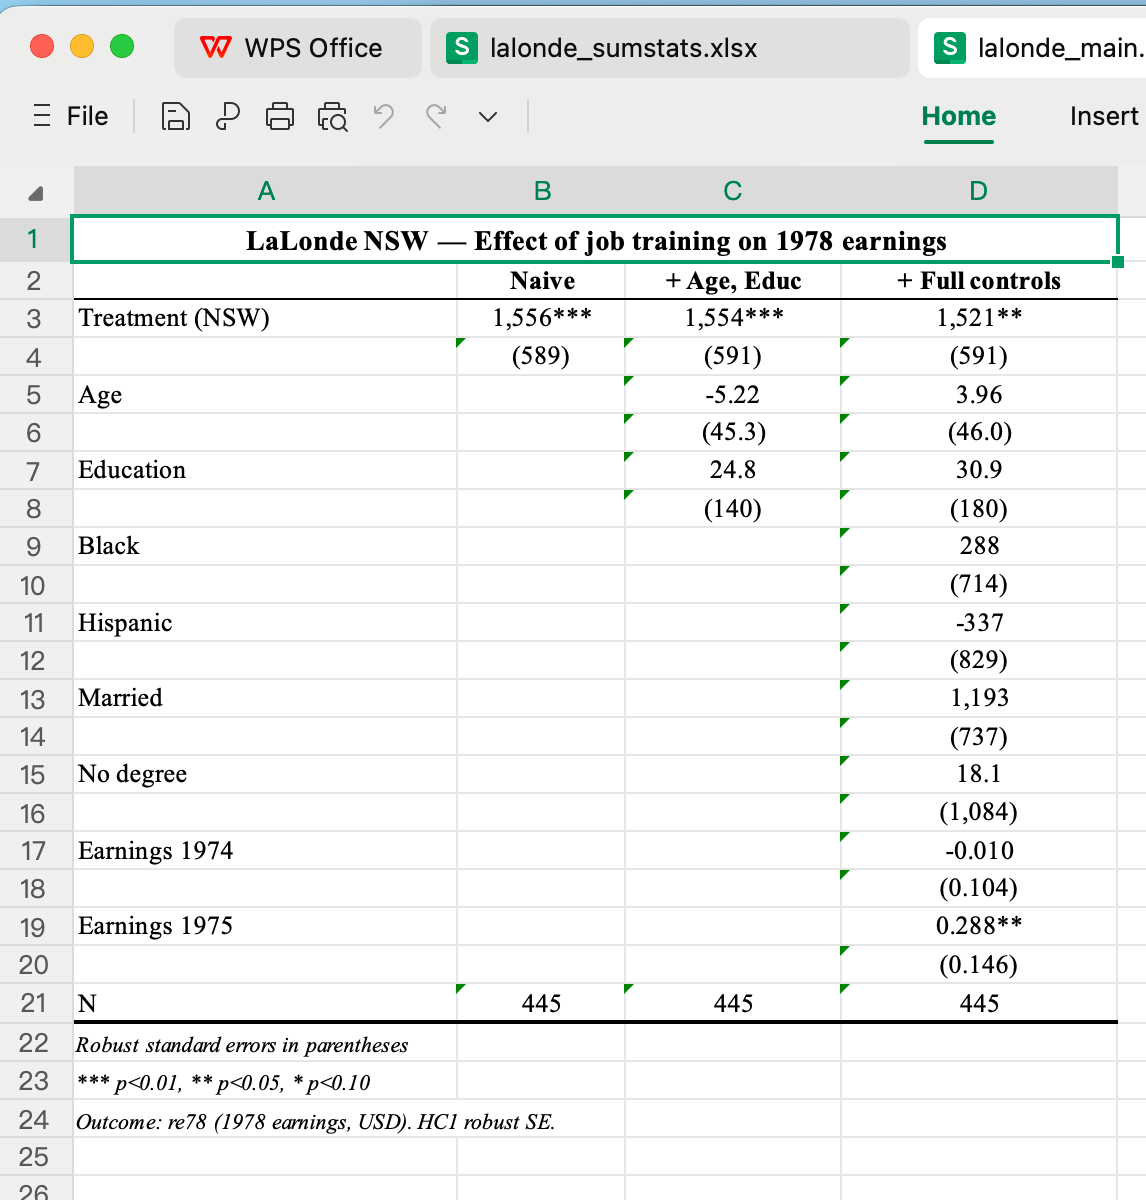
两张图是 tbl.to_excel() 写出的 .xlsx 文件经 LibreOffice 渲染的结果:上面是 Card (1995) 表;下面是 LaLonde/NSW 表,用带 PSID 对照组的数据把 1978 年收入回归到 NSW 培训处理上。LaLonde 表同时也是对观测数据比较的一个提醒:控制干预前收入和人口特征后,处理系数从 -635 变成 +1,548。期刊模板、标准误格式和单模型导出见导出指南。
交互式图表编辑
如果你怀念 Stata 的 Graph Editor,可以对 StatsPAI 返回的任意 matplotlib 图使用
sp.interactive(fig)。它会在 Jupyter 里打开一个带实时预览的编辑面板,新手不用先记住
matplotlib 的所有参数,也能把图调到适合论文或汇报的样子。需要 pip install "statspai[plotting]" ipywidgets。
它适合做这些事:
- 修改标题、坐标轴标签、字体、颜色、点线样式、网格、图例、坐标范围、图尺寸和导出 DPI;
- 在 StatsPAI 自带的论文主题(
academic、aea、minimal、cn_journal)与 matplotlib、seaborn 内置样式之间切换; - 保护数据图层,只编辑外观元素(默认
protect_data=True); - 自动导出可复现 Python 代码,避免最终图只停留在手工截图里。
import statspai as sp
mp = sp.datasets.mpdta()
gt = sp.callaway_santanna(data=mp, y="lemp", t="year",
                          i="countyreal", g="first_treat")
agg = sp.aggte(gt, type="dynamic", bstrap=False)
fig, ax = sp.ggdid(agg)
editor = sp.interactive(fig)   # 在 Jupyter 里编辑图表
print(editor.generate_code())  # 复制可复现的 matplotlib 编辑代码
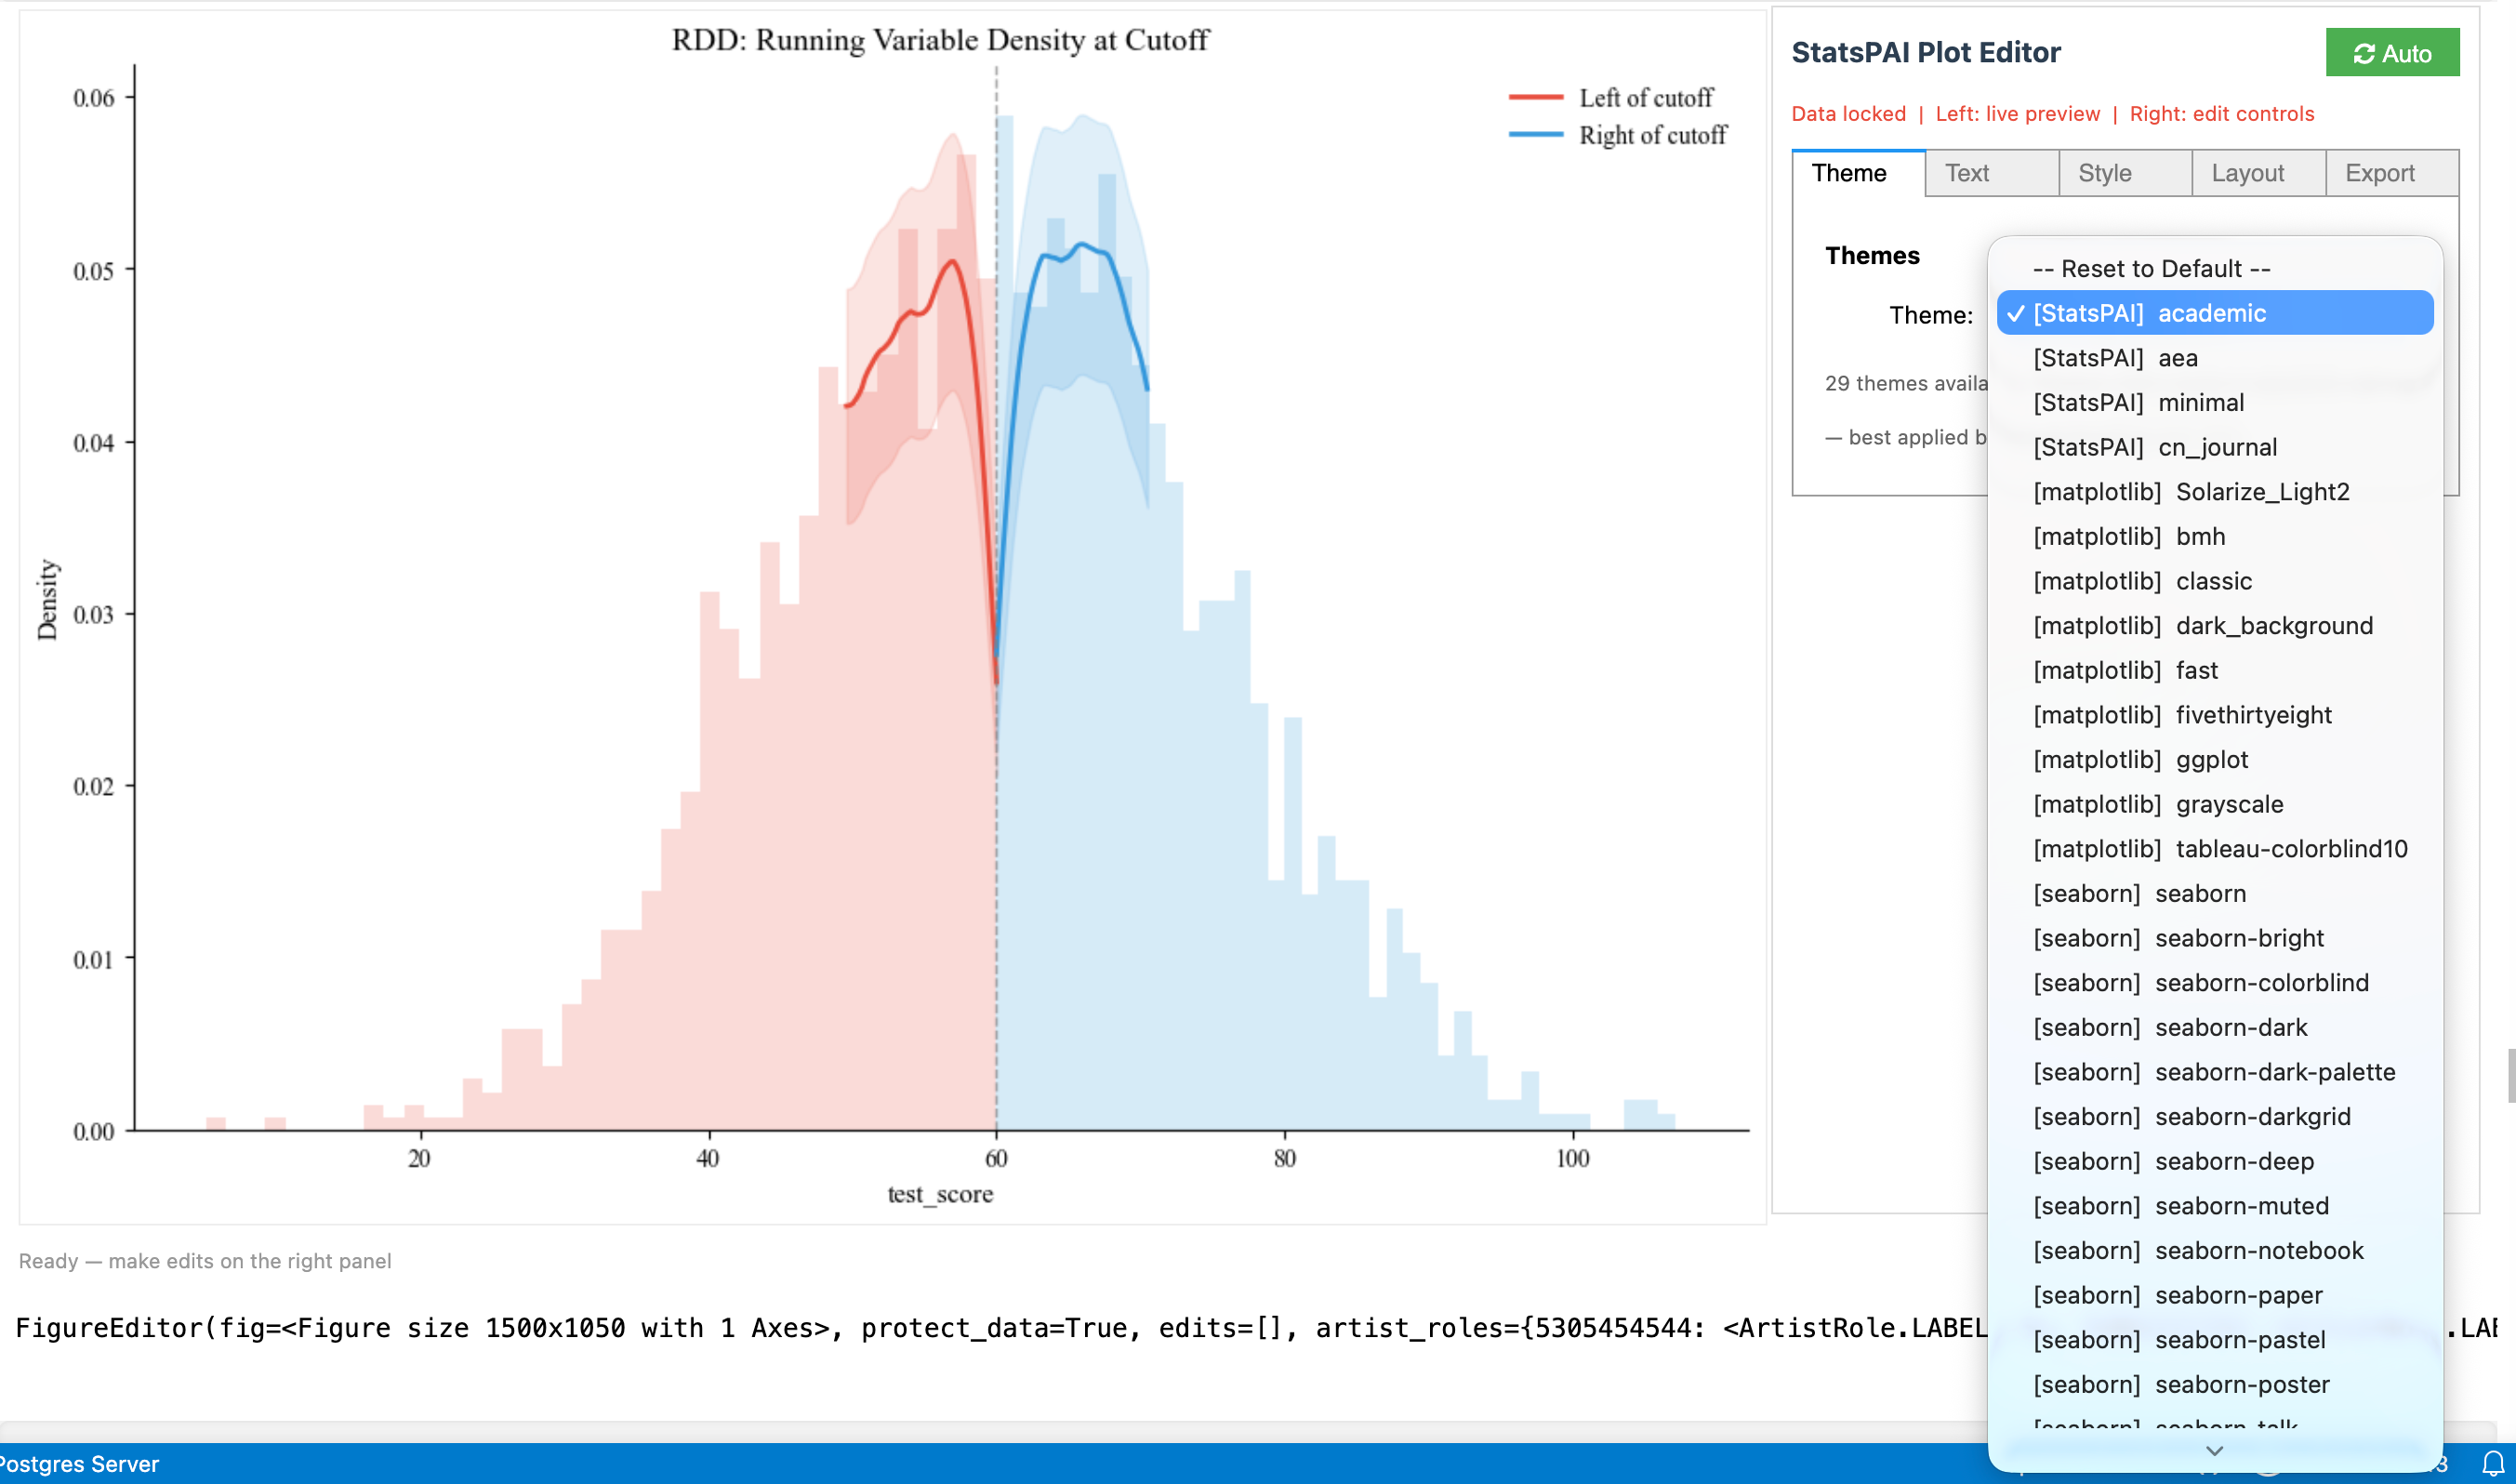
上面的截图展示了典型使用方式:一边预览图,一边调参数,最后导出可复现代码。
日常工作流
import statspai as sp
card = sp.datasets.card_1995()
r1 = sp.regress(
    "lwage ~ educ + exper + expersq + black + south + smsa",
    data=card,
    robust="hc1",
)
r2 = sp.ivreg("lwage ~ (educ ~ nearc4) + exper + expersq + black + south + smsa", data=card)
print(r1.summary())                          # 人类可读表格
print(r1.tidy().head())                      # broom 风格 dataframe
print(r1.test("black = south"))              # Wald 检验,对应 Stata 的 test
print(r1.lincom("black - south"))            # 对应 Stata 的 lincom
tbl = sp.regtable(r1, r2, model_labels=["OLS", "2SLS"])
tbl.to_word("table.docx")                    # Word 表
tbl.to_excel("results.xlsx")                 # Excel 表
常用文档:
- Getting started 与 Cookbook
- 选择估计器:DiD、
- 迁移:从 R 迁移、
- 证据:稳定性与验证分级、
在 Agent 中使用 StatsPAI
驱动 sp.help() 的同一个注册表,有三种使用方式。
在 Python 里——不读源码也能发现函数及其 schema:
import statspai as sp
sp.list_functions(core=True)                   # 约 30 个日常动词,按使用顺序
sp.list_functions(category="causal")[:5]      # 函数名
sp.describe_function("rdrobust")               # 参数、别名、验证状态
sp.function_schema("rdrobust")                 # 供工具调用的 JSON schema
sp.from_stata("reghdfe y x, absorb(id year) vce(cluster id)")
{'tool': 'feols', 'python_code': "sp.feols('y ~ x | id + year', data=df, cluster='id')", ...}
sp.stata("regress y x, vce(cluster id)", data=df) # 翻译并运行在命令行里——statspai list、statspai describe rdrobust、statspai search "synthetic control"。
通过 MCP——安装包时会附带 statspai-mcp stdio 服务(纯 Python,无额外依赖)。默认列出手工整理的估计器、工作流与流水线工具,外加三个发现类元工具(search_functions → describe_function → call_function),通过它们可以调用全部已注册函数;statspai-mcp --profile full 则把约 580 个自动生成的工具全部列出(约 2 MB,仅适合会分页加载工具的客户端)。另有工作流 prompts(例如 audit_did_result、stata_command_workflow)和 statspai://catalog 等 resources。工具接收 data_path(CSV、Stata .dta 以及 pandas 能读取的其他格式),返回带数据来源信息、运行期警告和未被接受参数清单的结构化 JSON。Claude Code 中:
claude mcp add statspai -- statspai-mcpClaude Desktop、Cursor 等其他客户端:
{
  "mcpServers": {
    "statspai": { "command": "statspai-mcp", "args": [] }
  }
}
数据交接、结果句柄以及推荐的 识别设计 → 估计 → 审计 流程见 MCP 工作流指南。
验证状态:哪些核验过,哪些还没有
StatsPAI 的 API 面很大,所以一定要看 validation status。
import statspai as sp
print(sp.describe_function("ivreg")["validation_status"])   # 'certified'
print(sp.list_functions(validation_status="certified")[:5])
每个注册函数都属于以下一档(数量对应当前 main;sp.list_functions(validation_status=...) 给出实时数字):
| validation_status | 含义 | 函数数 |
| --- | --- | ---: |
| certified | 在相同输入上与指定的外部参考实现(R、Stata,或方法作者维护的 Python 包)对照,落在预注册容差之内 | 414 |
| validated | 有已知真值模拟、已发表数字、覆盖率或有文档的约定差异等证据,但不在 R/Stata 主对齐 harness 中 | 128 |
| api_stable | 公开接口稳定;有单元测试,但不声明数值验证 | 641 |
| experimental | 方法或 API 仍可能变化 | 3 |
也就是说,目前大约三分之一的注册函数带有数值证据。覆盖面不等于验证,请检查你依赖的那些函数属于哪一档。
跨语言对齐,可查询
上面的分级由一套可审计的 parity 索引派生而来:每个通过验证的函数都记录了它对齐的参考实现是什么、容差是多少、由哪个测试守护、实际匹配到什么程度。每一行都能追溯到一个已提交的测试工件(版本锁定的 StatsPAI ↔ R ↔ Stata 对齐 harness,通过 renv.lock 加逐次运行的 provenance 固定)——没有任何结论是"凭记忆"断言的。
import statspai as sp
s = sp.parity_status("feols")
print(s)
feols: bit-exact vs fixest::feols [py/R/Stata] (headline rel_est 5.2e-15 within rel_est<=1e-06, rel_se<=1e-06)
s["reference_versions"]          # {'R': 'R version 4.5.2 (2025-10-31)', 'fixest': '0.14.0'}
sp.parity_summary()              # 覆盖统计,包括尚未验证的缺口
sp.parity_matrix(status="bit-exact")
等级:bit-exact(相对指定 R/Stata 参考实现的主指标相对误差 ≤ 1e-6)、aligned(有文档、预注册的较宽容差)、analytical-only(还原已知 DGP 真值或闭式恒等式)、external-replication(复现已发表论文数字)、unverified(已注册但尚无 parity 证据——诚实标注的缺口)。完整的自动生成矩阵发布在 docs/parity.md。
对你自己的数据,sp.cross_validate 会把同一个估计量交给本机已安装的每个独立引擎重跑,并报告它们是否一致:
card = sp.datasets.card_1995()
cv = sp.cross_validate(card, "iv", y="lwage", endog=["educ"], instruments=["nearc4"],
                       covariates=["exper", "expersq", "black", "south", "smsa"])
print(cv.summary())
Engine Estimate Std.Err 95% CI status
------------------------------------------------------------------------
statspai 0.13229 0.04923 [0.0358, 0.2288] ok
pyfixest 0.13229 0.04923 [0.0358, 0.2288] ok
linearmodels 0.13229 0.04923 [0.0358, 0.2288] ok
R::fixest 0.13229 0.04923 [0.0358, 0.2288] ok
------------------------------------------------------------------------
VERDICT: ✓ AGREE (4/4 engines ran)未安装的引擎(pyfixest,或带 fixest 的 R)会被跳过。每个引擎都按同一个方差估计量(包括 cluster= 与 vcov=)和同一套小样本修正来计算,所以比较的不只是点估计,还有标准误。
除了点估计对齐,Track-B 覆盖研究对每个估计量跑 B=1000 次蒙特卡洛重复,检查 95% 置信区间在已知真值 DGP 上是否达到名义覆盖率,接受带为 99% Wilson 区间 [0.935, 0.967]。13 个已物化 nominal 行(12 个已知真值 DGP)——RCT 上的 OLS (0.952)、2×2 DiD (0.955)、强工具 IV (0.962)、Callaway–Sant'Anna 交错 ATT (0.947)、Sun–Abraham 总体 ATT (0.950)、双向固定效应面板(sp.panel 0.948,sp.fast.feols 0.955)、熵平衡 (0.945)、2,000 棵树的 causal-forest AIPW ATE (0.959)、DML IRM ATE (0.968)、SDID 安慰剂 SE (0.928)、sharp RD robust CI (0.934)、默认学习器的 DML PLR (0.883)——每行同时记录偏差、Monte Carlo 标准差和 SE 校准比。SDID 与 RD 的不足伴随校准良好的 SE(RD 的区间与 R rdrobust 逐次抽样一致);PLR 的不足来自默认梯度提升干扰函数的正则化偏差(用真实干扰函数时为 0.95),详见 tests/coverage_monte_carlo/FINDINGS.md。已提交的工件在 tests/coverage_monte_carlo/results_b1000/。
Changelog
版本历史已经独立到 README 之外:
- CHANGELOG.md:完整版本记录。
- MIGRATION.md:弃用说明,以及会改变数值的正确性修复。
- Docs changelog page:文档站渲染版。
论文
StatsPAI 的同行评审论文已发表于 Journal of Open Source Software(2026, 11(125), 10604):
引用
如果在研究中使用 StatsPAI,请优先引用 JOSS 论文,并同时引用具体估计器背后的方法论文。sp.citation() 返回论文引用,sp.citation(which="software") 返回带版本号的软件引用,许多结果对象也提供 estimator-level citation helpers。
JOSS 论文页面,2026 年 9 月 3 日发表
@article{wang2026statspaijoss,
  author  = {Wang, Biaoyue and Rozelle, Scott},
  title   = {StatsPAI: A Unified, Agent-Native Python Toolkit for
             Causal Inference and Applied Econometrics},
  journal = {Journal of Open Source Software},
  year    = {2026},
  volume  = {11},
  number  = {125},
  pages   = {10604},
  doi     = {10.21105/joss.10604},
  url     = {https://doi.org/10.21105/joss.10604}
}
@software{wang2026statspai,
  author  = {Wang, Biaoyue and Rozelle, Scott},
  title   = {StatsPAI: A Unified, Agent-Native Python Toolkit for
             Causal Inference and Applied Econometrics},
  year    = {2026},
  version = {1.29.0},
  doi     = {10.5281/zenodo.19933900},
  url     = {https://doi.org/10.5281/zenodo.19933900},
  license = {MIT}
}
许可证
MIT。见 LICENSE。